Veo 4 详解:它是什么以及如何使用
深入理解 Veo 4 如何革新 AI 视频生成。了解其核心功能、工作流程及提升视频质量的实用技巧。支持高清、长时长、多镜头视频创作。
Veo3 AI · 3 min read · Sep 29, 2026
截至2026年末,尚无经官方确认的谷歌产品名为 Veo 4,Veo 3.1 仍是官方产品线中最新且已验证的模型。当前切实可行的选择是:先深入掌握 Veo 3.1 的实际生成能力,再将所有关于 Veo 4 的规格参数或发布声明均视为未经证实的推测——直至谷歌正式发布相关文档。
你可能是通过搜索结果中看到的“Veo 4 发布日期”、某视频工具页面列出的功能清单,或社交媒体上宣称“支持更长镜头与更强角色一致性”的帖子而来到此处。这种困惑完全可以理解。AI 视频模型的命名传播极快,非官方页面常将预测性内容与已确认的产品信息混排呈现。对创作者而言,真正有价值的问题不仅在于“Veo 4 未来可能是什么?”,更关键的是:当下你能稳定用于实际生产的工具有哪些?
目录
- 厘清当前围绕 Veo 4 的讨论
- Veo 3.1 当前实际能为你的视频创作带来什么
- Veo 技术架构如何提升视频质量
- Veo 3.1 与其他 AI 视频生成器的对比
- 面向社交媒体与营销的实用提示词模板
- 关于 Veo 4 的常见误解与定价疑问
- 你在 2026 年开展 AI 视频创作的下一步行动
<a id="understanding-the-veo-4-conversation-right-now"></a>
厘清当前围绕 Veo 4 的讨论
“Veo 4”一词目前描述的更多是一场公众讨论,而非一款已确认的谷歌产品。多家独立报道指出:截至2026年9月,谷歌尚未宣布、记录或发布任何 Veo 4 的模型卡、API 规范或定价说明;而 Veo 3.1 仍是谷歌官方产品线中最新且经确认的模型。一份关于 Veo 4 现状的综述 将这一区别作为核心论点。
这为创作者提供了一个简单的验证标准:真正的发布应体现于谷歌或谷歌 DeepMind 的官方公告、Gemini API 或 Vertex AI 模型的公开页面、模型卡、版本更新日志,或定价文档中。独立网站上罗列的功能清单或许有助于了解市场预期,但绝不能作为该产品已存在、或所列功能已可使用的证据。
<a id="why-the-rumor-cycle-feels-convincing"></a>
为何谣言循环显得如此可信
Veo 系列迭代迅速,使得下一代模型的推出似乎已成定局。独立的时间线追踪显示,Veo 3.1 将于 2025 年 10 月发布,并指出此前惯用的“5 月发布”模式已不再能可靠预测后续版本。截至 2026 年 5 月,谷歌仍未公布 Veo 4 的路线图,这一点在 Veo 版本时间线分析 中已有明确说明。
结果是陷入一种危险的中间状态:名称耳熟能详,预测的功能看似合理,创作者也亟需一款能突破当前局限的工具;但“看似合理”不等于“已获证实”。在谷歌正式公布 Veo 4 的模型身份与完整文档之前,请以 Veo 3.1 为工作流核心,并仅在 Veo 4 成为真实、有据可查的正式发布版本后,再予以评估。
<a id="what-veo-31-can-actually-do-for-your-videos"></a>
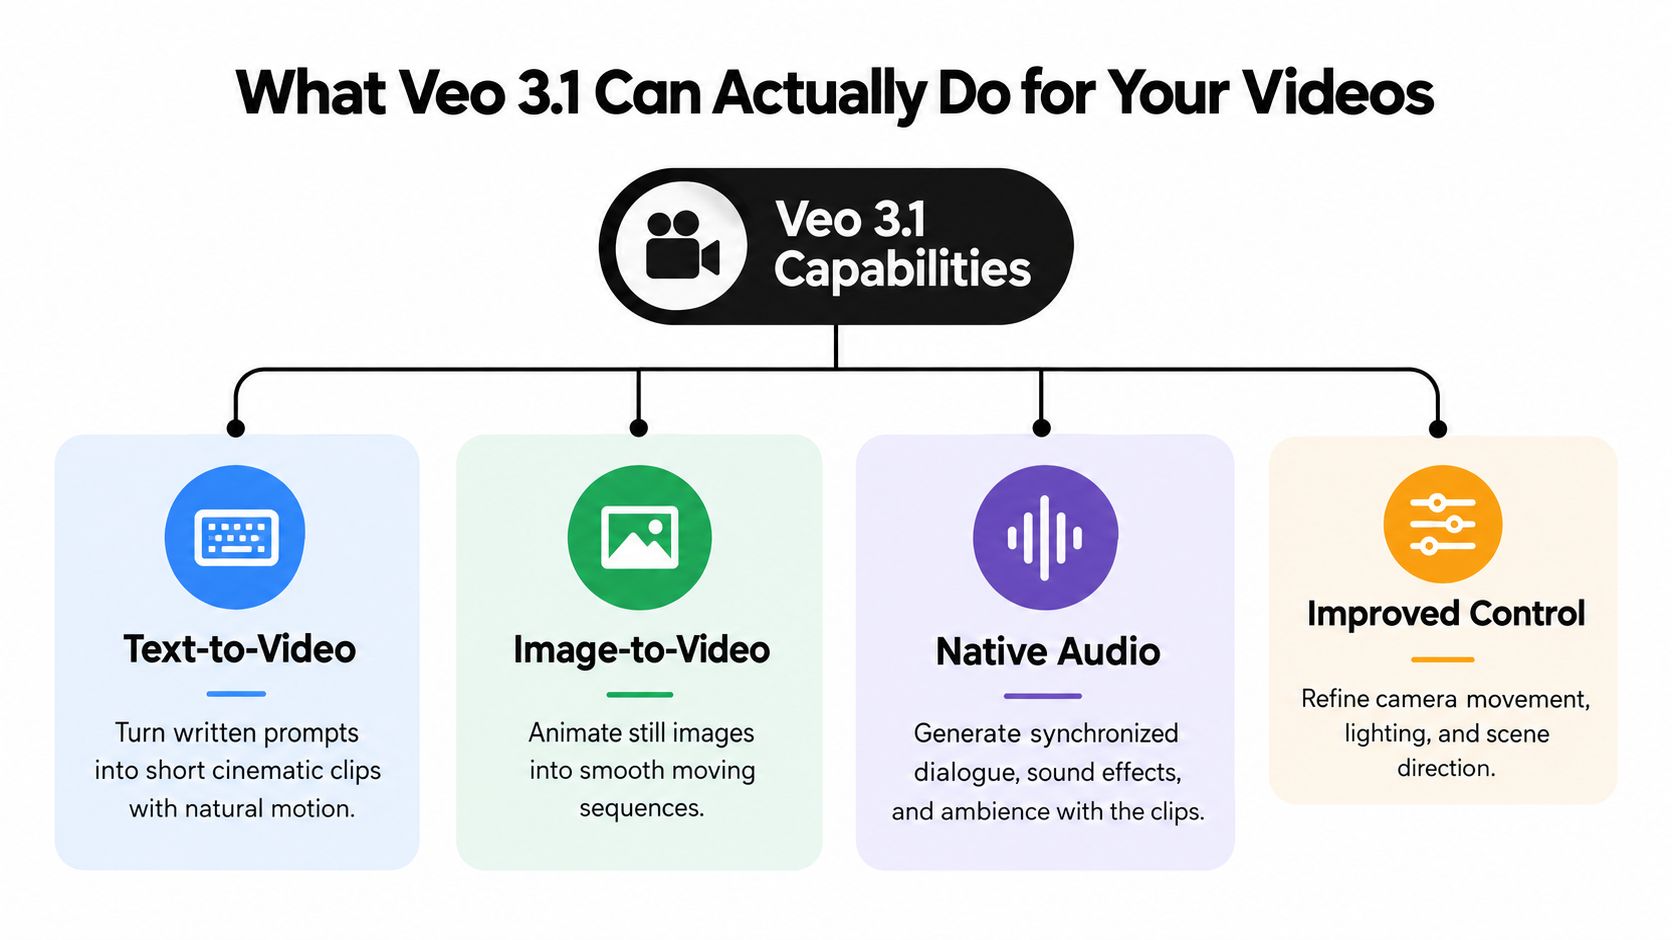
Veo 3.1 究竟能为你的视频带来什么
Veo 3.1 为创作者提供了切实可用的基准能力,而非捕风捉影的传闻。谷歌 DeepMind 的 Veo 模型页面 明确记载其支持 720p、1080p 和 4K 分辨率生成。关键限制在于:4K 仅限 8 秒片段,且 Gemini Enterprise 文档中仅确认支持 24 FPS。
这意味着 Veo 3.1 非常适合制作短场景、产品特写、视觉测试及面向社交平台的内容。但它并不意味着你能一次性生成整部无中断的 4K 长片。对于更长的项目,你需要构建一套整合工作流——例如拼接多个片段、扩展单个场景,或后期剪辑组合多个独立镜头。
<a id="match-the-output-to-the-platform"></a>
根据目标平台匹配输出规格
标准生成支持固定时长选项:4 秒、6 秒 或 8 秒;而“Extend(延伸)”功能可在基础时长之上继续生成内容。一份企业级报告指出,在该工作流下,延伸后的片段最长可达 148 秒,详见 Google Cloud 的 Veo 3.1 提示词指南。
同时,支持的 16:9 和 9:16 两种宽高比也至关重要:
- 选用 9:16 适配以移动端优先的 TikTok、YouTube Shorts 及 Instagram Reels 内容;
- 选用 16:9 适配常规 YouTube 视频、演示文稿及宽幅广告素材。
请将每次生成的短视频视为一个独立“镜头”,而非期待模型单次输出即完成完整剪辑。
<iframe width="100%" style="aspect-ratio: 16 / 9;" src="https://www.youtube.com/embed/LgoJoMAdNC8" frameborder="0" allow="autoplay; encrypted-media" allowfullscreen></iframe>
若想实际体验已确认的能力基线,欢迎访问 Veo 3.1 视频生成器。建议从一个清晰主体、一个明确动作、一种简单运镜开始尝试——这有助于快速判断问题根源:是提示词设计不当、场景构思有误,还是模型本身存在能力边界。
<a id="how-veos-technical-architecture-improves-video-quality"></a>
Veo 的技术架构如何提升视频质量
一段视频即使画面吸睛,也可能令人感觉“违和”:声音延迟抵达、脚步声未与肢体动作同步、对白口型无法匹配说话者……Veo 的技术路径正是在生成阶段就直面这一问题,而非将音频视作事后添加的独立音轨。
Google Veo 技术文档 指出,Veo 3 采用跨时间维度音频隐空间与时空视频隐空间联合应用的潜在扩散模型(latent diffusion)。通俗来说,该系统将声音与动态影像的表征统一处理,并同步建模它们随时间的变化过程。
<a id="a-simple-analogy"></a>
一个简单类比
想象两位导演共同拍摄同一场戏。在第一种工作流中,一人负责拍摄画面动作,另一人后期单独添加脚步声和对白——虽然最终效果可以协调,但所有音效都需手动对齐;而在第二种工作流中,导演从一开始就将演员走位、镜头运动与声音设计视为一个整体事件来统筹规划。
Veo 的耦合式表征更接近第二种方式:音频与视频并非完全割裂的后期任务,因此模型在协调动作、节奏、环境氛围与对白方面具备更坚实的基础。
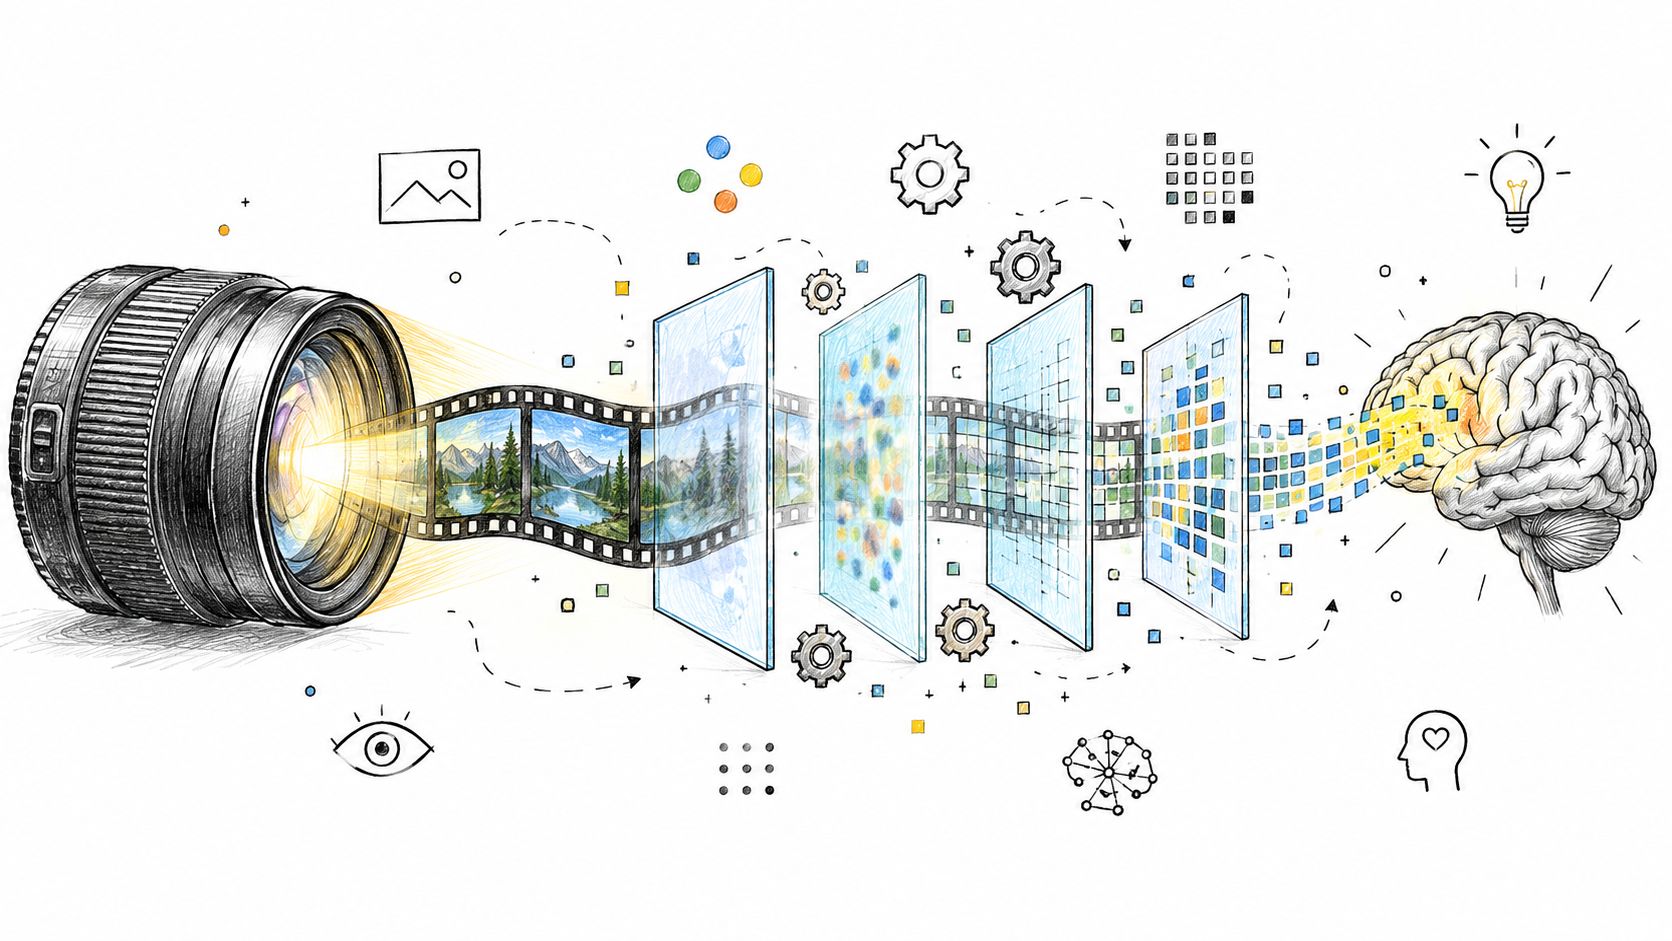
这并不意味着每个生成片段都完美无瑕:提示词仍可能模糊、画面仍可能偏移、生成语音仍需人工审核。但这种架构差异至关重要——因为音画同步是模型协同输出的固有组成部分,而非视频渲染完成后再额外配上的音轨。
实用原则: 将动作及其对应声音一并描述。“一名骑行者急刹,轮胎在湿滑路面上刺耳摩擦”比仅描述视觉画面更能为模型建立强关联的音画关系。
<a id="comparing-veo-31-with-other-ai-video-generators"></a>
Veo 3.1 与其他 AI 视频生成工具对比
创作者极少孤立地选择某一款模型。他们通常将 Veo 3.1 与 Seedance、Hailuo、MiniMax H3、Kling 3.0 等工具横向比较,再根据具体任务需求、目标格式以及工作流所能承受的迭代次数做出决策。更多可选工具详见本指南:面向内容创作者的最佳 AI 工具。
下表聚焦实际使用场景,保持对比务实。当公开验证资料未明确说明某款替代工具的具体能力时,表格中相应条目将避免虚构精确参数。
<a id="ai-video-generator-comparison"></a>
AI 视频生成器对比表
| 工具 | 最高分辨率 | 典型片段时长 | 最适用场景 |
|---|---|---|---|
| Veo 3.1 | 8 秒片段支持 4K | 4、6 或 8 秒(支持 Extend 延展工作流) | 音画同步场景、电影感测试、竖版或横版社交平台内容 |
| Seedance | 因产品及调用路径而异 | 因工作流而异 | 快速实验各类生成式视频创意 |
| Hailuo | 因产品及调用路径而异 | 因工作流而异 | 低门槛视觉构思与短片生成 |
| MiniMax H3 | 因产品及调用路径而异 | 因工作流而异 | 对比不同模型的运镜表现与提示词响应行为 |
| Kling 3.0 | 因产品及调用路径而异 | 因工作流而异 | 对比运镜逻辑、视觉风格与场景生成思路 |
Veo 3.1 在原生音频支持、明确标注的分辨率选项,以及同时支持 16:9 和 9:16 输出格式等关键维度上表现突出。若创作者更看重某种特定视觉风格,或希望尝试不同的生成工作流,则其他模型可能更为合适。基准测试无法替你做出这一判断——建议使用相同简短提示词,在各工具中分别生成视频,再逐一评估其运动表现、声音质量、角色一致性、文字呈现效果及后期编辑所需投入。
像 Veo3 AI 这样的全栈式平台,将 Veo3、Seedance 和 Hailuo 等多个生成模型整合于同一环境之中,有助于减少在不同服务间频繁切换的需要,从而更高效地横向比对输出效果。请直接查阅 Veo3 AI 定价页面,以获取最新访问权限详情,因套餐条款可能随时调整。
<a id="practical-prompt-templates-for-social-media-and-marketing"></a>
社交媒体与营销场景下的实用提示词模板
优质提示词如同精炼的分镜指令:需清晰指出主体、动作、场景、镜头行为、光线、声音、画幅比例及预期情绪。它无需过于技术化,但应尽可能消除本可避免的歧义。
<a id="for-a-vertical-social-clip"></a>
适用于竖版社交短视频
“9:16 竖版视频。一只陶瓷咖啡杯静置于阳光洒落的厨房台面上。一缕蒸汽缓缓升腾,一只手将肉桂棒轻轻放在杯旁。镜头缓慢推进,晨光温暖柔和,环境音轻柔自然,构图简洁干净,画面中不添加任何字幕。”
画幅比例直接指导生成器如何构图;“缓慢推进”为镜头运动设定了明确方向,而非放任其自由发挥;声音提示则服务于场景氛围营造,而非要求生成完整配乐。
<a id="for-a-product-advertisement"></a>
适用于产品广告
“16:9 产品展示视频。一双黑色跑鞋在哑光石质底座上缓慢旋转。柔光摄影精准呈现鞋底纹理细节。镜头从低角度起始,平稳过渡至特写细节镜头。面料运动清晰利落,整体调性克制而高端,除所提供产品本身外,画面中不出现任何品牌标识。”
该提示词将核心动作(产品旋转)与视觉处理(灯光、运镜、质感)明确区分开来。若用于真实品牌项目,须补充经官方批准的产品参考资料,并在发布前逐项核验所有生成内容。
<a id="for-a-short-narrative"></a>
适用于短叙事视频
“一位年轻面包师于黄昏时分关闭小店,听见窗外雨声初起,此时一位顾客折返,只为买走最后一块面包。共三组连贯镜头,人物服饰与外貌保持一致,采用轻柔手持镜头拍摄,室内暖光随镜头渐变为街道冷光,配以真实自然的雨声环境音。”
切勿试图单次生成复杂故事。建议先生成开场镜头,审阅后,再通过延续提示(continuation prompt)或新提示词重新生成后续镜头——其中需重复强调人物特征与场景设定。当创作者将生成结果视为可供剪辑的原始素材(coverage),而非成片时,角色与场景的一致性将显著提升。
若以静态图片为起点,可这样启动动画:“对此图像添加缓慢的从左至右平移镜头;保持人物面部、服装及背景建筑结构完全不变;在画面中加入树木的微风摇曳效果与自然室内环境音。” 先生成基础视频片段,再逐项优化细节。
<a id="common-misconceptions-and-pricing-questions-about-veo-4"></a>
关于 Veo 4 的常见误解与定价问题
最大的误解是:某网页宣称“Veo 4 已发布”,就等同于 Google 已正式推出 Veo 4。事实并非如此。近期部分独立报道声称,Veo 4 将于 2026 年 4 月通过 Google Flow 和付费版 Gemini Ultra 上线,而免费用户则被导向 Google Vids 中的 Veo 3.1。然而,这些说法与更广泛的已验证记录相冲突——截至 2026 年底,尚无广泛确认的 Veo 4 官方发布信息、模型卡(model card)、API 规范或定价表。因此,关于所谓访问模式的报道 应视为未经证实的消息,而非购买保障。
这一区别至关重要,因为实际采购相关的核心问题仍未得到解答。公开页面往往未说明:付费访问具体包含哪些权益?不同接入路径是否存在使用限制差异?创作者每月可生成多少视频?重复执行同一工作流时,产出可用成片的成功率如何?缺少这些细节,便无法合理评估订阅价值,也难以计算单条成品视频的实际成本。
<a id="questions-creators-should-test"></a>
创作者应实测的关键问题
- 角色一致性:同一人物在不同镜头剪辑中是否始终保持可识别性?
- 编辑控制力:能否仅修改某一物体或台词,而不必重生成整段场景?
- 多镜头叙事能力:工作流能否稳定保留道具、服饰及空间关系?
- 本地化支持:是否能恰当处理日语或韩语的对白、字幕、标牌及文化语境?
- 制作可靠性:生成一条可用的 TikTok 或 Instagram Reels 广告,平均需迭代多少次?
这些问题关乎实际工作流,而非宣传口径中的亮点功能。若您同时在对比高频视觉内容生产的成本,请将视频生成能力与 批量图像工作流的定价信息 区分开来——图像与视频生成面临截然不同的生产约束。
较低的接入价格,并不自动意味着单条可用成片的成本更低。失败生成次数与后期编辑耗时,同样应计入总成本核算。
<a id="your-next-steps-for-ai-video-creation-in-2026"></a>
您在 2026 年开展 AI 视频创作的下一步行动
请从具备已验证可用能力的工具入手,而非仅关注搜索结果中出现频率最高的版本名称。对于大多数正在评估 Google 视频产品线的创作者而言,这意味着:以小规模、可复现的简短需求为起点,实测 Veo 3.1,并以编辑所需投入(而非单纯视觉新颖性)作为核心评估指标。
请使用以下检查清单:
- 选定一种画幅格式:短内容营销活动从 9:16 开始;宽屏概念演示则选用 16:9。
- 撰写一条受控提示词:明确指定主体、动作、运镜方式、布光、音效及视频时长。
- 生成多个变体:横向对比连续性、运动表现、音画同步性、干扰元素及文字渲染效果。
- 完成一次剪辑:将短输出视作独立镜头,在您惯用的剪辑软件中进行组装。
- 尝试替代方案:当需要不同动效风格或工作流适配时,可测试 Seedance、Hailuo、MiniMax H3 或 Kling 3.0。
- 持续关注 Google 官方渠道:真正的 Veo 4 发布应伴随官方公告、模型文档、API 标识符、定价信息或模型卡(model card)。
保留您的提示词、参考图片、选定的视频片段以及拒绝理由记录。无论未来谷歌是否推出 Veo 4,还是您最终选定其他生成模型,该素材库都将持续发挥价值。它还能为您提供客观依据,用以评估模型的实际改进效果,而非依赖传言驱动的功能列表。
若您希望在不频繁切换创作工具的前提下对比多个模型,Veo3 AI 提供了一站式环境,支持将文本提示或静态图片直接生成视频,并可同时调用多种生成式模型。欢迎访问 Veo3 AI,体验实用工作流、横向对比生成结果,并借助当前可用的工具快速构建短视频或营销创意方案。
Related Articles
Continue with more blog posts in the same locale.
Higgsfield Genjutsu 对比 Veo 3.1:哪款 AI 视频工具更适合你?
Higgsfield Genjutsu 改已有素材,Veo 3.1 从文字或图片生成新视频。对比输入方式、时长、音频和适用场景,帮你选对工具。
Read article
Google Flow 免费吗?定价、积分与使用限制(2026)
Google Flow 免费吗?讲清每日 50 积分、Google AI 订阅价格、每条 Veo 3.1 视频的积分消耗、高峰时段限制,以及免费额度实际能做多少。
Read article
Gemini Omni 费用详解:创作者的定价层级
Gemini Omni 费用拆解:面向消费者与 API 的定价、Token 计费模型、分辨率相关成本,以及短视频创作者可享的免费使用选项。
Read article